前端 JS 混淆到底藏了什么:从七种混淆手段到 AST 还原,再聊聊反爬攻防这场拉锯战
混淆不是加密,能跑就能还原。这篇把标识符重命名、字符串数组、控制流平坦化等七种常见混淆手段一招招拆开,再用 Babel/AST 给出可本地复现的还原代码;后半程站在防守方视角讲透反爬五层防线(请求特征/参数签名/环境检测/行为分析/验证码)与合规边界。全程自建 demo,不涉及任何具体站点逆向。
前端 JS 混淆到底藏了什么:从七种混淆手段到 AST 还原,再聊聊反爬攻防这场拉锯战
写在前面。
这几年做前端和数据相关的活儿,绕不开两件事:一是别人的 JS 为什么读不懂,二是为什么有的数据你正常请求就是拿不到。这两件事其实是一回事的两面——前者是"代码混淆",后者是"反爬",而混淆常常就是反爬体系里的一环。
这篇我想把这两块讲透。不讲任何具体网站怎么破,也不给你"照着抄就能绕过某站"的脚本——那种东西既不合规,讲了也过两周就失效。我讲的是原理和通用方法:混淆是怎么把一段人能读的代码变成天书的,我们又用什么思路把它还原回来;以及反爬这套攻防体系,双方各自在哪几层博弈、为什么这么设计。
所有例子我都用自己写的 demo 代码来演示,你在自己电脑上 node 一跑就能复现,不依赖任何外部站点。看完你应该能建立起一套"看到混淆代码不慌、知道从哪下手"的思维框架。
小白也能看:我会尽量把每个术语第一次出现时讲清楚。
一、先搞清楚:混淆到底在防谁
很多人第一次打开一个网站的 JS,看到满屏的 _0x3a2f、while(!![])、一长串十六进制数组,第一反应是"这是加密了吧?解不开了"。
先纠正一个概念:混淆(obfuscation)不是加密(encryption)。
- 加密是可逆的数学变换,没有密钥就还原不出明文。
- 混淆是把代码变得难读但功能不变——它必须能在浏览器里正常跑起来,所以浏览器能执行它,理论上你也一定能还原它。混淆增加的是阅读和分析的成本,不是让你彻底拿不到。
这一点想通了,心态就稳了:只要它能跑,就能被还原。区别只是花多少力气。
那混淆是防谁的?主要三类:
- 防抄代码:前端逻辑(比如某个计费规则、某个动画算法)不想被同行直接复制。
- 防篡改:怕别人改了你的 JS 再注入页面(比如改掉支付金额)。
- 抬高逆向门槛:这就是反爬的核心用途了——把"生成请求签名的那段逻辑"藏起来,让爬虫写不出正确的请求。
我们这篇主要关心第 3 类,但手段是通用的。
下面这张图是同一段功能代码,混淆前后的对比,先有个直观感受:
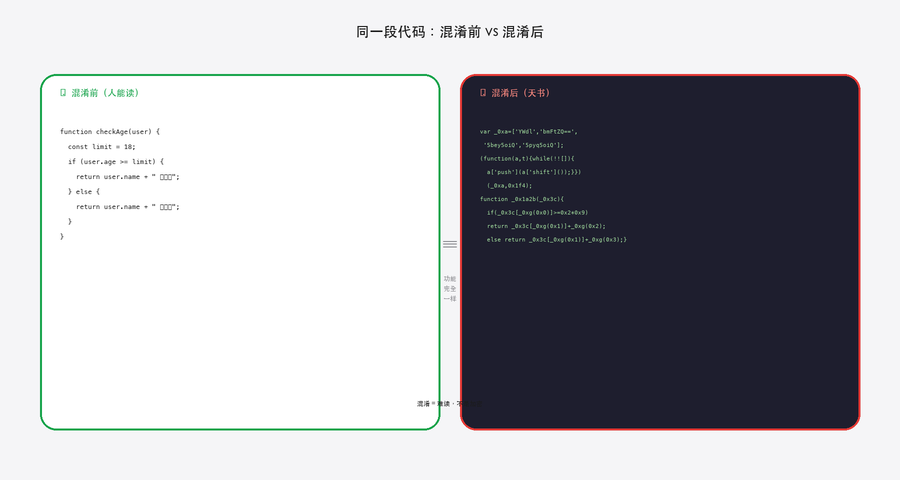
左边人能一眼看懂,右边……你盯十分钟也未必知道它在算什么。但两段代码跑出来的结果完全一样。这就是混淆。
二、混淆的七种常见手段(每种都配 demo)
市面上的 JS 混淆器(最有名的是开源的 javascript-obfuscator,很多商用方案也是在它思路上加料)翻来覆去就那么几招。我把它们拆开,一招一招讲。
我们拿这段"人话代码"当靶子,后面每一招都对它施法:
// demo.js —— 原始代码
function checkAge(user) {
  const limit = 18;
  if (user.age >= limit) {
    return user.name + " 已成年";
  } else {
    return user.name + " 未成年";
  }
}
console.log(checkAge({ name: "小明", age: 20 }));
招式 1:标识符重命名(identifier renaming)
最基础的一招:把有意义的变量名、函数名全换成 _0x 开头的十六进制乱码。
function _0x1a2b(_0x3c4d) {
  const _0x5e6f = 18;
  if (_0x3c4d['age'] >= _0x5e6f) {
    return _0x3c4d['name'] + ' 已成年';
  } else {
    return _0x3c4d['name'] + ' 未成年';
  }
}
注意两个细节:
user变成了_0x3c4d,checkAge变成了_0x1a2b。名字本身没有任何含义,纯粹为了让你读不出"这个变量是干嘛的"。user.age被写成了_0x3c4d['age']——把点号访问改成方括号+字符串访问。这一步是为下一招"字符串加密"铺路的,先记住。
还原思路:重命名是不可逆的(原始名字信息已经丢了),但你可以边读边给它改回有意义的名字。现代 IDE 的"重命名符号"(rename symbol)功能能把一个变量的所有引用一次性改掉,读代码时看懂一个就改一个,越读越清晰。
招式 2:字符串加密 + 字符串数组(string array)
这是混淆的灵魂招式,几乎所有反爬 JS 都有。
思路是:把代码里所有的字符串字面量('age'、' 已成年' 这些)抽出来,塞进一个大数组,然后代码里用下标去取。
// 所有字符串集中到一个数组
const _0xarr = ['age', 'name', ' 已成年', ' 未成年'];

function _0x1a2b(_0x3c4d) {
  const _0x5e6f = 18;
  if (_0x3c4d[_0xarr[0]] >= _0x5e6f) {      // _0xarr[0] === 'age'
    return _0x3c4d[_0xarr[1]] + _0xarr[2];  // 'name' + ' 已成年'
  } else {
    return _0x3c4d[_0xarr[1]] + _0xarr[3];
  }
}
现在你光看 _0xarr[0] 完全不知道它是 'age',得回头去数组里数下标。混淆器还会再加一层:给数组包一个取值函数,并且经常做 Base64 或异或(XOR)编码,取的时候再解回来:
const _0xarr = ['YWdl', 'bmFtZQ==', '5bey5oiQ5bm0'];  // Base64 编码后的字符串

function _0xget(i) {
  return atob(_0xarr[i]);   // atob 是浏览器自带的 Base64 解码
}

// 用的时候:_0xget(0) 运行时才解出 'age'
到这一步,你在源码里搜不到任何明文字符串了——想找"哪段代码拼了'签名'这个词"都无从下手。这就是它对付逆向的核心价值。
还原思路:这一招虽然唬人,但破法很固定。因为取值函数(_0xget)就在代码里,你把字符串数组和取值函数原样抠出来,在 node 里跑一遍,然后把代码里所有 _0xget(0)、_0xget(1) 的调用,替换成它实际返回的字符串。这个"替换"用手工做会累死,所以后面第三章我们用 AST 自动做。核心口诀就一句:能在本地跑出结果的,就把调用替换成结果。
招式 3:字符串数组乱序 + 自解密(array rotate)
上一招还有个弱点:数组里字符串的顺序是固定的,多看几遍还能对上号。所以混淆器再加一手——开局先把数组打乱一次。
它会在文件最开头塞一段"自执行函数"(IIFE),干的事是:把数组循环左移若干位,位数由一个校验值决定。这样你直接看数组,下标和内容对不上,必须让这段自解密代码先跑一遍,数组才是"正确"的顺序。
const _0xarr = ['bmFtZQ==', '5bey5oiQ5bm0', 'YWdl'];  // 故意乱序的

(function (arr, target) {
  // 不停把数组头挪到尾,直到某个校验值等于 target 才停
  while (true) {
    try {
      const check = parseInt(atob(arr[0])) / 1;  // 伪代码:某种校验
      if (check === target) break;
      arr.push(arr.shift());   // 左移一位
    } catch (e) {
      arr.push(arr.shift());
    }
  }
})(_0xarr, 0x1f4);
它的阴险之处在于:这段代码必须完整跑完数组才是对的,你没法只静态看。而且校验逻辑经常写得很绕,让你不敢轻易删。
还原思路:别去读懂那段自解密逻辑,没必要。直接把"字符串数组 + 自解密 IIFE + 取值函数"这三块整体抠出来,在 node 里执行,让它自己把数组转正。转正之后的取值函数,就是你后面用来还原的工具。这就是逆向里很重要的一个心法——别跟混淆器拼智力,让它自己给你算答案。
招式 4:数值与表达式变换(number & expression transform)
把常量拆成一堆运算,让你看不出真实值。
// 原始:const limit = 18;
const _0x5e6f = 0x2 * 0x9;              // 2 * 9 = 18
// 或者更狠:
const _0x5e6f = -0x1 * -0x12 + 0x0;     // 还是 18
// 布尔值也不放过:
if (!![]) { ... }                        // !![] 就是 true
if ([] == ![]) { ... }                   // 这个也是 true(JS 类型转换的坑)
!![]、[]==![] 这种是利用 JavaScript 类型隐式转换的"抽象操作",很多新手看到直接懵。但它们的值是恒定的:!![] 永远是 true,![] 永远是 false。
还原思路:这些都是常量表达式,没有变量参与,可以直接"求值折叠"(constant folding)——2*9 直接算成 18。同样,手工做累,AST 一把梭。
招式 5:控制流平坦化(control flow flattening)
这是最劝退的一招,也是商用混淆的重头戏。
正常代码的执行顺序是"从上往下、遇到 if 分叉",逻辑结构和代码结构是对应的。控制流平坦化把这个对应关系彻底打乱:它把每一段代码切成块,塞进一个 switch,再用一个"调度器"变量决定下一步跳到哪个 case。
function _0x1a2b(_0x3c4d) {
  // "0|1|2" 这个字符串规定了执行顺序
  const _order = '0|2|1|3'.split('|');
  let _i = 0;
  let name, ok;
  while (true) {
    switch (_order[_i++]) {
      case '0':
        name = _0x3c4d['name'];
        continue;
      case '1':
        ok = _0x3c4d['age'] >= 18;
        continue;
      case '2':
        // 这里其实先执行
        continue;
      case '3':
        return name + (ok ? ' 已成年' : ' 未成年');
    }
    break;
  }
}
你去读这个 switch,case '0'、case '1'、case '2' 谁先谁后?光看代码结构完全不知道——真正的顺序藏在 _order 那个 '0|2|1|3' 字符串里。而且真实混淆里 case 会有几十上百个,_order 那个字符串也被加密了。这就是它劝退的原因:代码的物理顺序和逻辑顺序被故意解耦了。
还原思路:核心就一句——找到那个"派发字符串"(_order),按它规定的顺序把 case 重新排回去。派发器变量是整个平坦化的"钥匙",找到它,其余的就是按顺序拼装。这个后面用 AST 演示。
招式 6:僵尸代码 / 花指令(dead code injection)
往代码里塞一堆永远不会执行、或者执行了也不影响结果的垃圾代码,纯粹为了淹没真正的逻辑。
if (0x1 === 0x2) {                 // 永远为假,整块是死代码
  const _0xdead = window['xxxx'];
  document['yyy'](_0xdead);
}
const _0xreal = user['age'];       // 这一行才是真的
while (_0x9a8b()) {                // _0x9a8b 恒返回 false
  console['log']('never runs');
}
一段真正有用的代码,可能被十几段这样的垃圾包围。你读的时候一半精力都耗在辨别"这段到底跑不跑"上。
还原思路:判断条件是常量的分支(if(false)、if(1===2)),可以直接整块删掉;恒假的循环同理。这类清理也归到 AST 里的"死代码消除"(dead code elimination)。
招式 7:eval 套壳 + 反调试(self-defending / anti-debug)
最外层的保护。两个东西:
① eval / Function 套壳:把真正的代码变成一个字符串,运行时才用 eval() 或 new Function() 把它"解出来"执行。你在文件里看到的可能只是一坨字符串拼接。
const _0xcode = atob('ZnVuY3Rpb24gY2hlY2tBZ2Uo...');  // 一大段 Base64
eval(_0xcode);   // 运行时才把真正的函数解出来
② 反调试(anti-debug):检测你有没有打开浏览器开发者工具(F12)。常见手法是死循环 debugger 语句——一旦你开着 DevTools,代码执行到 debugger 就会卡住,让你没法正常单步调试。
setInterval(function () {
  (function debugCheck() {
    debugger;              // 开着 DevTools 就会在这里断住
    debugCheck();          // 递归再调,让你根本停不下来
  })();
}, 100);
有的还会检测代码有没有被"美化"(格式化)过——它把关键函数 toString() 出来算长度,你一格式化长度就变了,它就知道代码被动过手脚,直接罢工。
还原思路:
eval套壳:把eval(x)改成console.log(x),让它把要执行的代码打印出来而不是执行,你就拿到了里层代码。这是逆向里最经典的一步——"脱壳"。- 反调试的
debugger:多数浏览器支持在断点上右键选"Never pause here"(永不在此暂停),或者用条件断点。也可以在 AST 层面直接把debugger语句节点删掉。
到这儿,七招讲完了。你会发现一个规律:几乎每一招的还原,最后都指向同一个工具——AST。下面就讲它。
三、还原的核心武器:AST(抽象语法树)
前面每一招的还原思路里,我都反复说"手工做累死,交给 AST"。这一章就把 AST 讲明白,并给出可以直接跑的代码。
3.1 什么是 AST
AST 全称 Abstract Syntax Tree,抽象语法树。一句话:把代码从"字符串"变成"树形数据结构",让程序能像操作对象一样操作代码。
举个最小的例子,const a = 1 + 2; 这行代码,在 AST 眼里长这样(简化):
VariableDeclaration (kind: const)
└─ VariableDeclarator
   ├─ id: Identifier (name: "a")
   └─ init: BinaryExpression (operator: "+")
      ├─ left:  NumericLiteral (value: 1)
      └─ right: NumericLiteral (value: 2)
为什么这东西能对付混淆?因为混淆的所有花样,在 AST 里都是有规律的节点结构:
- 字符串数组取值
_0xget(0)→ 一个CallExpression节点。 - 常量运算
2 * 9→ 一个两边都是NumericLiteral的BinaryExpression。 - 死代码
if(false){...}→ 一个test是false的IfStatement。
我们要做的,就是写规则去匹配这些节点,然后改写或删除它们。改完再把树"打印"回代码字符串,就是还原后的结果。
这套"字符串 → AST → 改 → 打印回字符串"的流程,就是所有专业还原工具(包括各种"JS 解混淆"网站)的底层原理。
3.2 工具:Babel
处理 JS 的 AST,业界标准是 Babel(就是那个把 ES6 转 ES5 的编译器,它内部全靠 AST)。装四个包:
npm install @babel/parser @babel/traverse @babel/generator @babel/types
四个包各管一段流水线:
@babel/parser:parse,把代码字符串解析成 AST。@babel/traverse:遍历,像走迷宫一样访问树上每个节点,是我们写规则的地方。@babel/types:judge/构造节点,判断"这是不是一个数字字面量"、"新建一个字符串节点"。@babel/generator:generate,把改完的 AST 打印回代码字符串。
一个最小骨架:
const parser = require('@babel/parser');
const traverse = require('@babel/traverse').default;
const generate = require('@babel/generator').default;
const t = require('@babel/types');

const code = `const a = 2 * 9;`;

// 1. 解析成 AST
const ast = parser.parse(code);

// 2. 遍历 + 改写
traverse(ast, {
  // 访问每一个"二元表达式"节点
  BinaryExpression(path) {
    // ...在这里写规则
  },
});

// 3. 打印回代码
const output = generate(ast).code;
console.log(output);
path 是 Babel 给你的"节点操作把手":path.node 是当前节点本身,path.replaceWith(...) 换掉它,path.remove() 删掉它。记住这几个就够开工了。
3.3 实战一:常量折叠(对付招式 4)
把 2 * 9 这种纯常量运算直接算成结果。规则:如果一个二元表达式两边都是字面量,就地求值。
traverse(ast, {
  BinaryExpression(path) {
    const { left, right } = path.node;
    // t.isLiteral 判断是不是字面量(数字、字符串等)
    if (t.isLiteral(left) && t.isLiteral(right)) {
      // Babel 提供的静态求值:能算的话返回 {confident:true, value:...}
      const { confident, value } = path.evaluate();
      if (confident) {
        path.replaceWith(t.valueToNode(value));  // 用结果节点替换整个表达式
      }
    }
  },
});
0x2 * 0x9 会被直接替换成 18,-0x1 * -0x12 也会变成 18。path.evaluate() 是 Babel 自带的求值器,很多常量表达式它能直接算出来,非常省事。
3.4 实战二:死代码消除(对付招式 6)
把 if(false){...} 这种恒假分支删掉,恒真分支则"拆掉外壳保留内容"。
traverse(ast, {
  IfStatement(path) {
    const { confident, value } = path.get('test').evaluate();  // 求值判断条件
    if (!confident) return;   // 条件不是常量,跳过,别乱删
    if (value) {
      // 条件恒真:用 if 体替换整个 if 语句
      path.replaceWithMultiple(path.node.consequent.body);
    } else {
      // 条件恒假:如果有 else 就留 else,否则整块删掉
      if (path.node.alternate) {
        path.replaceWith(path.node.alternate);
      } else {
        path.remove();
      }
    }
  },
});
关键是那句 if (!confident) return;——条件不是常量就绝对不能动,否则你会把真实的业务分支误删。逆向里"宁可少删,不可错删"。
3.5 实战三:还原字符串数组(对付招式 2、3)
这是最能体现"让混淆器自己算答案"心法的一步。做法分两步:
第一步,把三块东西抠出来在本地跑:字符串数组、自解密 IIFE、取值函数。假设扒出来长这样:
// decoder.js —— 从目标文件原样复制的三块
const _0xarr = ['YWdl', 'bmFtZQ==', '5bey5oiQ5bm0', '5pyq5oiQ5bm0'];
(function (arr, t) { /* 自解密,原样复制 */ })(_0xarr, 0x1f4);
function _0xget(i) { return atob(_0xarr[i]); }

module.exports = _0xget;   // 导出,给还原脚本调用
第二步,遍历目标 AST,把所有 _0xget(数字) 的调用,替换成它实际返回的字符串:
const decode = require('./decoder.js');   // 引入上面跑通的取值函数

traverse(ast, {
  CallExpression(path) {
    const callee = path.node.callee;
    const args = path.node.arguments;
    // 匹配形如 _0xget(数字) 的调用
    if (t.isIdentifier(callee, { name: '_0xget' })
        && args.length === 1
        && t.isNumericLiteral(args[0])) {
      const real = decode(args[0].value);         // 本地真跑,拿到明文
      path.replaceWith(t.stringLiteral(real));     // 用明文字符串节点替换
    }
  },
});
跑完之后,满屏的 _0xget(0) 就都变回 'age'、'name' 这些明文了。代码的可读性一下子恢复大半——因为字符串是代码里含义最集中的东西,字符串一还原,逻辑基本就能读了。
这一步为什么必须"本地真跑取值函数"而不是自己去推导编码算法?因为取值函数里可能套了 Base64、XOR、甚至自定义查表,你去逐个逆推太慢也容易错。它自己就是最准的还原器,直接用它。
3.6 实战四:控制流平坦化的还原思路(对付招式 5)
平坦化是最难的,但思路清晰:找到派发字符串,按它的顺序把 case 重排回去。
回顾招式 5 那段代码,switch 的执行顺序藏在 '0|2|1|3'.split('|') 里。还原步骤:
- 定位派发器:找到那个
while(true){ switch(...) }结构,以及控制它的那个"顺序字符串 + 自增下标"。 - 取出真实顺序:把
'0|2|1|3'解出来 →[0, 2, 1, 3]。 - 建立 case 映射:把每个
case '0'、case '1'的函数体(去掉continue)收集成一张表{ '0': [...语句], '1': [...语句] }。 - 按序拼装:按
[0,2,1,3]的顺序,把对应 case 的语句依次拼成一个正常的、从上往下的语句块,替换掉整个while-switch。
代码骨架(核心逻辑,实际要处理更多边界):
traverse(ast, {
  WhileStatement(path) {
    // 1. 确认这是个平坦化结构(body 里只有一个 switch)
    const body = path.node.body.body;
    if (body.length !== 1 || !t.isSwitchStatement(body[0])) return;
    const switchStmt = body[0];

    // 2. 找到派发顺序数组(需结合上下文定位那个 '0|2|1|3' 常量)
    const order = findDispatchOrder(path);   // 你的定位逻辑
    if (!order) return;

    // 3. 把每个 case 的语句体收进映射表(剔除 continue/break)
    const caseMap = {};
    for (const c of switchStmt.cases) {
      const key = c.test.value;
      caseMap[key] = c.consequent.filter(
        s => !t.isContinueStatement(s) && !t.isBreakStatement(s)
      );
    }

    // 4. 按真实顺序把语句拼接起来,替换整个 while
    const restored = [];
    for (const key of order) {
      restored.push(...(caseMap[key] || []));
    }
    path.replaceWithMultiple(restored);
  },
});
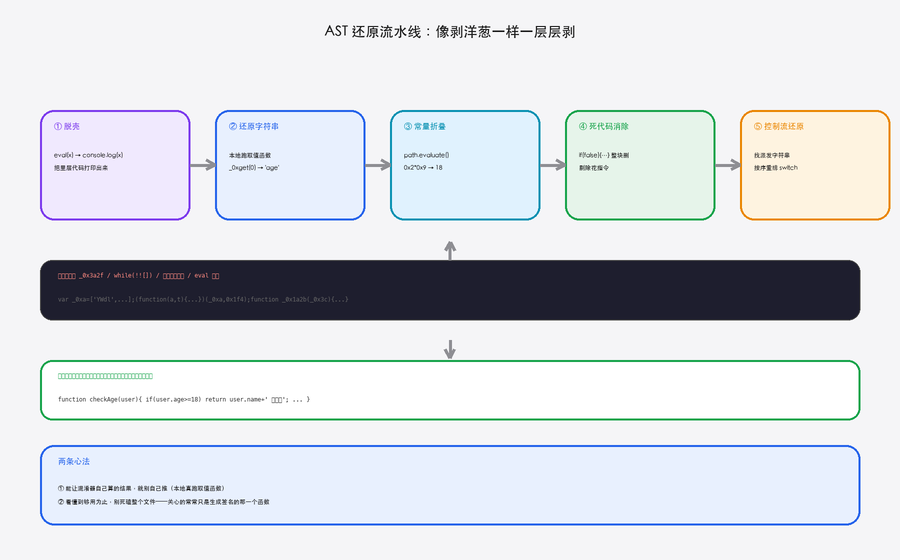
难点在第 2 步"定位派发顺序"——真实混淆里那个字符串常常也被加密了,你得先把前面的字符串还原跑完,它才是明文。所以还原是有先后顺序的:先脱 eval 壳 → 再还原字符串数组 → 再常量折叠 → 再死代码消除 → 最后处理控制流平坦化。一层层剥,像剥洋葱。
下面这张图把这个"剥洋葱"的流水线画出来了:
3.7 一个务实的提醒
不是所有代码都值得还原到底。真实场景里,一个几万行的混淆文件,你真正关心的往往只是其中一个函数(比如生成某个参数的那段)。这时候更聪明的办法是"局部还原 + 动态调试"结合:静态还原到能读懂调用关系,然后在浏览器里对着那个函数下断点,直接看它的输入输出,而不是死磕每一行。
逆向的目标是"看懂到够用为止",不是"把整个文件洗成新的"。 分清主次,能省下大量时间。
四、反爬攻防:这是一场没有终局的拉锯
讲完混淆,我们把视角拉高,看它在整个"反爬"体系里处于什么位置。
先摆一个态度:这一章我站在防守方视角讲。因为只有理解了平台"为什么这么防、防在哪几层",你无论是做数据采集还是做自己网站的防护,才有全局观。我不给任何"绕过某站"的具体步骤——那既不合规,也不是这篇的目的。
4.1 平台为什么要反爬
不是平台小气。爬虫失控会带来实打实的问题:
- 服务器成本:恶意高频抓取相当于一次小型 DDoS,正常用户反而卡。
- 数据资产:商品价格、评论、用户内容是平台的核心资产,被批量搬走等于被白嫖。
- 业务安全:批量注册、刷单、抢券、爬取个人信息,背后往往是黑灰产。
- 合规责任:平台上有大量用户个人信息,被爬取泄露,平台要担法律责任。
所以反爬本质是区分"人"和"机器",并对机器限流或拦截。难点在于:做得太松挡不住机器,做得太紧误伤真人。整个攻防的精妙都在这个平衡上。
4.2 反爬的五层防线
我把常见的反爬手段按"从外到内"分成五层。下面这张图是全景:
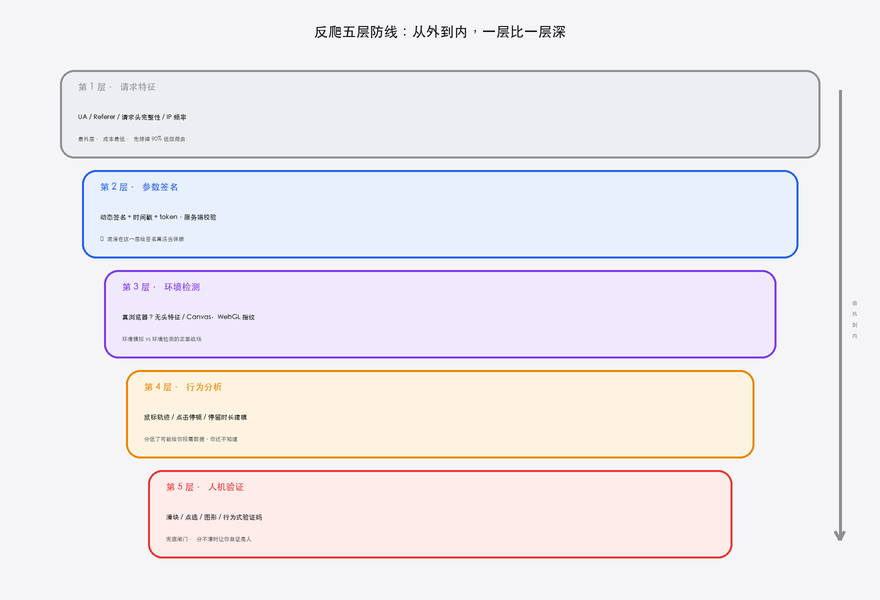
第一层:请求特征(最外层,成本最低)
检查 HTTP 请求本身像不像真人浏览器:
- User-Agent:有没有 UA,是不是
python-requests这种一眼假的。 - Referer / Origin:请求是不是从合理的页面跳来的。
- 请求头完整性:真浏览器会带一整套
Accept、Accept-Language、sec-ch-ua等头,脚本常常只带几个。 - 频率与 IP:同一个 IP 每秒几十次请求,明显是机器。
这层最好过也最好防,属于"基础体检"。防守方用它先筛掉 90% 的低级爬虫。
第二层:参数签名(把逻辑藏进 JS)
关键接口要求请求里带一个动态签名参数(各家叫法不同,本质都是"用一套算法把请求参数 + 时间戳 + 密钥算出一个校验值")。服务端用同样算法验一遍,对不上就拒绝。
这就是前面混淆的用武之地:生成签名的那段 JS 被重度混淆,让你没法轻易复刻算法。签名里通常还掺了时间戳(请求有时效,隔几秒就失效)和token(服务端下发、会过期),进一步抬高门槛。
第三章讲的所有还原手段,主要就是为了读懂这一层。
第三层:环境检测(你是不是真浏览器)
光有请求头还不够,平台会用 JS 检测运行环境是不是真的浏览器:
- 有没有
window、document、真实的 DOM。 - 无头浏览器(headless)的特征,比如某些
navigator属性缺失或异常。 - 浏览器指纹:把 Canvas 绘图结果、WebGL 信息、字体列表、屏幕分辨率等拼起来算一个 hash,同一台机器指纹稳定,用来识别"又是这个爬虫"。
这一层是"环境模拟"和"环境检测"的直接对抗,也是最烧脑的战场。
第四层:行为分析(你的操作像不像人)
真人操作有"人味":鼠标轨迹是连续曲线不是瞬移、点击有随机停顿、滚动有加速度、页面停留时间符合阅读习惯。机器往往是"精确、匀速、无停顿"。平台把这些行为数据收集起来做建模,给每个会话打一个"人类可信度"分。
分低了不一定马上封,可能给你返回真假掺半的数据(投毒)、或者悄悄弹验证码——这比直接拒绝更难受,因为你甚至不知道自己被识破了。
第五层:验证码与人机验证(最后的闸门)
前面几层拿不准时,抛一个验证码给你——滑块、点选、图形识别、行为式验证。这是"确实分不清了,让用户自己证明是人"的兜底手段。
4.3 为什么说这是"拉锯"
因为每一层的攻防都是动态演进的,没有一劳永逸:
- 你把请求头补全了 → 它上参数签名。
- 你把签名算法逆出来了 → 它把签名 JS 混淆升级、加上环境检测。
- 你用真浏览器(自动化框架)绕过环境检测 → 它上行为分析,看你鼠标像不像人。
- 你把行为也模拟得像了 → 它调整算法、换指纹维度、加验证码。
防守方每加一层,攻击方的成本就上一个台阶;攻击方每破一层,防守方就迭代下一版。 双方都在动,所以任何"永久有效的绕过方法"都不存在——这也是我为什么不写具体绕过步骤:写出来的当天可能还行,平台一迭代就废了,徒增合规风险还没长期价值。
真正有价值的是理解这套分层模型:你做采集时能判断"卡在哪一层了",做防护时知道"我该补哪一层"。方法论比脚本值钱。
4.4 合规这条线,必须画清楚
技术能做到,不代表可以做。这几条是硬边界:
- 看 robots.txt 和用户协议:平台明确禁止抓取的,别碰。
- 别碰个人信息:姓名、手机号、身份证、住址这类,抓取和使用都受法律严格约束(个人信息保护法)。
- 别影响对方正常服务:高频请求把人家服务器打挂,可能构成破坏计算机信息系统。
- 别绕过付费墙/权限墙:需要登录、付费才能看的内容,绕过鉴权去拿,性质就变了。
- 公开数据也有边界:能公开访问 ≠ 能随意批量采集再商用。
我的原则很简单:优先用官方开放接口 / API;确实没有、且数据是公开非个人信息、且不影响对方服务、且不违反协议时,才考虑技术采集,并严格限速。 技术是中性的,但用它的人得守住线。
五、小结:一套能带走的思维框架
写了这么多,最后把可以随身带走的东西压缩成几句话。
关于混淆:
- 混淆不是加密,能跑就能还原,区别只是花多少力气。
- 七种手段——重命名、字符串数组、数组乱序、数值变换、控制流平坦化、死代码、eval套壳+反调试——本质都是"抬高阅读成本"。
- 还原的总纲是 AST:字符串 → 语法树 → 按规则改写 → 打印回代码。
- 还原有顺序,像剥洋葱:脱壳 → 还原字符串 → 常量折叠 → 死代码消除 → 控制流还原。
- 核心心法两条:能让混淆器自己算的结果,就别自己推;看懂到够用为止,别死磕全文件。
关于反爬:
- 五层防线从外到内:请求特征 → 参数签名 → 环境检测 → 行为分析 → 验证码,一层比一层深。
- 混淆是第二层"参数签名"的保镖,这就是混淆和反爬的连接点。
- 攻防是动态拉锯,没有永久有效的绕过;有价值的是分层模型这套方法论。
- 合规是硬线:robots、个人信息、服务可用性、鉴权墙、商用边界,一条都不能踩。
这篇没有给你任何"拿去就能破某站"的东西,是故意的。逆向真正的功力,从来不在于收藏了多少现成脚本,而在于看到一坨天书代码时,你知道它是怎么变成天书的,也知道该从哪一层、用什么工具把它一层层剥回去。
这套思维框架,比任何一段会过期的脚本都耐用。
(本文所有代码均为自建 demo,可在本地 node 环境复现;不针对、不涉及任何具体网站或平台的逆向过程。)
评论 0