我攒了个 Mac 桌面数据面板:Token 账单 + 供应商切换 + 工作日志 AI 助手(已开源)
把 AI 编程的 token 账单、API 供应商一键切换、工作日志 AI 助手塞进一个 Electron 桌面面板——纯本地数据、手绘 SVG 图表、零图表库依赖。技术栈 Electron + Python + 一点 Swift,已开源。
最近把手头几个零散的小需求捏成了一个 Mac 桌面应用,自己每天开着用,顺手开源了。这篇记录一下它是什么、怎么搭起来的,以及几个我觉得值得单独拿出来讲的实现细节。
先说它解决我什么问题:
- 我用 Claude Code、Codex 写代码,一天下来到底烧了多少 token、花了多少钱,心里没数;
- 经常要在不同的 API 供应商之间切来切去,每次手动改
~/.claude/settings.json、~/.codex/config.toml,烦且容易改错; - 想要一个「今天我到底干了啥、有效时间多少」的复盘,但又不想手动记;
- 微信、钉钉、企业微信的未读散在三个 App 里,来回点。
于是就做了这个面板,把这几件事塞进一个窗口。
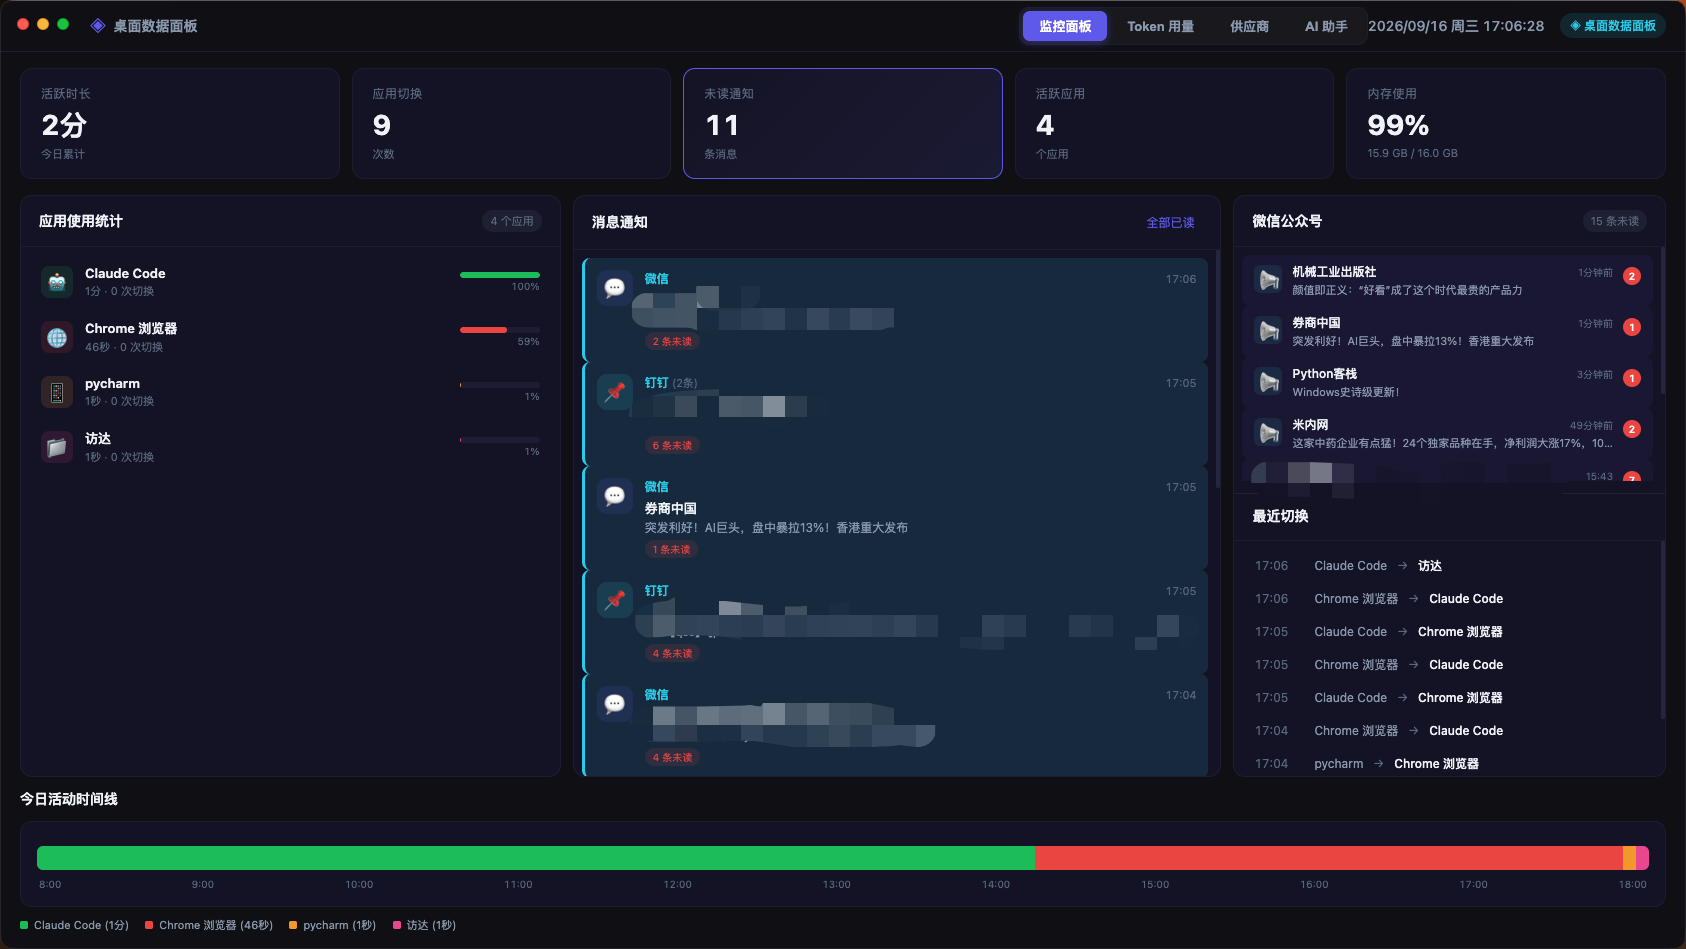
一、整体架构
技术选型很朴素:Electron 做壳和界面,重活交给 Python 子进程,几个跟系统打交道的小活用 Swift 原生写。
┌─────────────────────────────────────────────┐
│            Electron 主进程 (main.js)          │
│  ├── trackApp()   前台应用追踪 (AppleScript)  │
│  ├── checkBadges() Dock 角标检测 (Swift)      │
│  ├── read*Messages() 各家消息读取 (Python)     │
│  ├── get-usage-data  Token 用量 (Python)      │
│  ├── switch-provider 供应商切换 (Python)       │
│  └── ai-chat         工作日志助手 (Python)     │
├─────────────────────────────────────────────┤
│         Electron 渲染进程 (前端界面)           │
│  index.html + renderer.js + styles.css        │
│  五个页面:监控 / Token / 供应商 / AI,IPC 通信 │
├─────────────────────────────────────────────┤
│              外部脚本 (Python / Swift)         │
│  usage_reader.py / provider_manager.py /       │
│  ai_assistant.py / *_reader.py / notif-helper  │
└─────────────────────────────────────────────┘
为什么不纯 Node 一把梭?因为解析日志、跟本地数据库打交道这些活,Python 写起来顺手、生态也全(比如 AES 那套直接 pycryptodome)。主进程通过 child_process 调用 Python 脚本,脚本只干一件事:算完把结果打成 JSON 从 stdout 吐出来,主进程收下再通过 IPC 发给渲染进程画界面。各脚本之间互不依赖,单独拿出来在命令行跑也能用,调试很方便。
跟系统底层打交道的两个活单独用 Swift 编译成命令行小程序:一个监听 macOS 通知中心(notif-helper),一个读 Dock 图标上的未读角标数字(chat-scanner,走辅助功能 API)。这俩用 AppleScript / Node 都别扭,Swift 几十行搞定。
下面挑三个我自己最常开的二级页面细说。
二、AI 编程 Token 账单
这是我做得最上心的一页——把 Claude Code 和 Codex 的 token 消耗、预估费用算清楚。
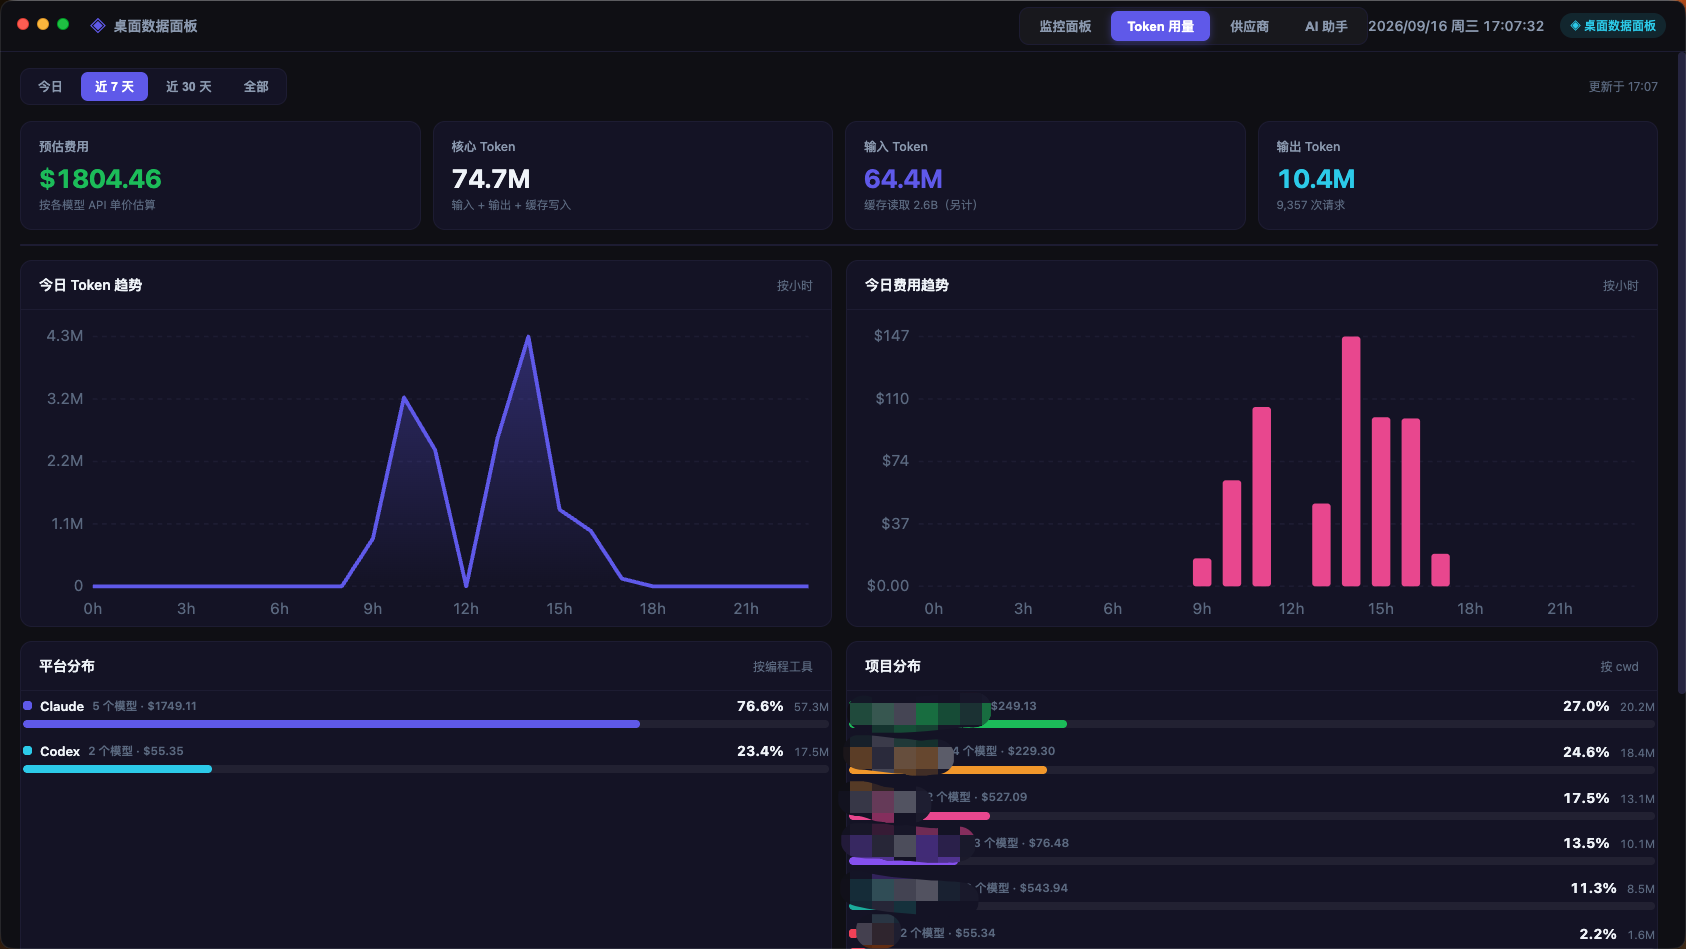
数据源是纯本地的,零外部依赖。 这两个工具都会把每一轮对话落到本地日志里,我直接解析:
- Claude Code:
~/.claude/projects/*/*.jsonl,每行一条 JSON。我只要message.role == "assistant"且带usage的行,字段是现成的:
import json, glob

for path in glob.glob(os.path.expanduser("~/.claude/projects/*/*.jsonl")):
    for line in open(path, encoding="utf-8"):
        if '"usage"' not in line:          # 先按字符串粗筛,省掉大量 json.loads
            continue
        d = json.loads(line)
        msg = d.get("message") or {}
        if msg.get("role") != "assistant":
            continue
        u = msg.get("usage") or {}
        tin  = u.get("input_tokens", 0)
        tout = u.get("output_tokens", 0)
        tcr  = u.get("cache_read_input_tokens", 0)      # 缓存读取
        tcw  = u.get("cache_creation_input_tokens", 0)  # 缓存写入
        model = msg.get("model")
        proj  = os.path.basename(d.get("cwd") or "")    # 项目名 = 工作目录最后一段
        hour  = d.get("timestamp", "")[:13]             # 落到「小时」桶
- Codex:
~/.codex/sessions、~/.codex/archived_sessions里的token_count事件(last_token_usage是逐轮增量),再从session_meta拿cwd和model。
几个口径上的坑,我是这么定的:
- 「核心 Token」= 新输入 + 输出 + 缓存写入,不含缓存读取。 为什么排掉缓存读取?因为同一段上下文会被反复读,缓存读取的数字会大到离谱(我这台一天缓存读取能到 2.6B),把它算进「用量」会完全盖住真实消耗。所以缓存读取单独列一栏,不进主口径。
- 费用按各模型的 API 单价,分 input / output / cache_read / cache_write 四类分别计——缓存读写单价和普通输入输出差很多,混着算就不准了。价格表内置在
usage_reader.py里(价格表和聚合维度参考了掘金的开源项目 jusage,MIT,但解析和实现是自己写的)。
图表全是手绘 SVG,一个图表库都没引。 趋势线就是把每小时的值归一化到 viewBox 高度,拼一串 M x,y L x,y ... 的 path;热力图是一格一个 <rect> 按数值深浅上色;环形占比是算每段的 stroke-dasharray。没有 ECharts 那些依赖,包体积小、渲染也快。
性能上,日志文件很多、还一直在长,每次全解析太慢。我按每个文件的 mtime + size 做缓存,把每文件的「小时级聚合桶」存下来,下次只重新解析变过的文件——首次全解析 2~3 秒,之后大概 35 毫秒。
三、AI 供应商一键切换
第二页,解决「手动改配置文件切供应商」的麻烦。
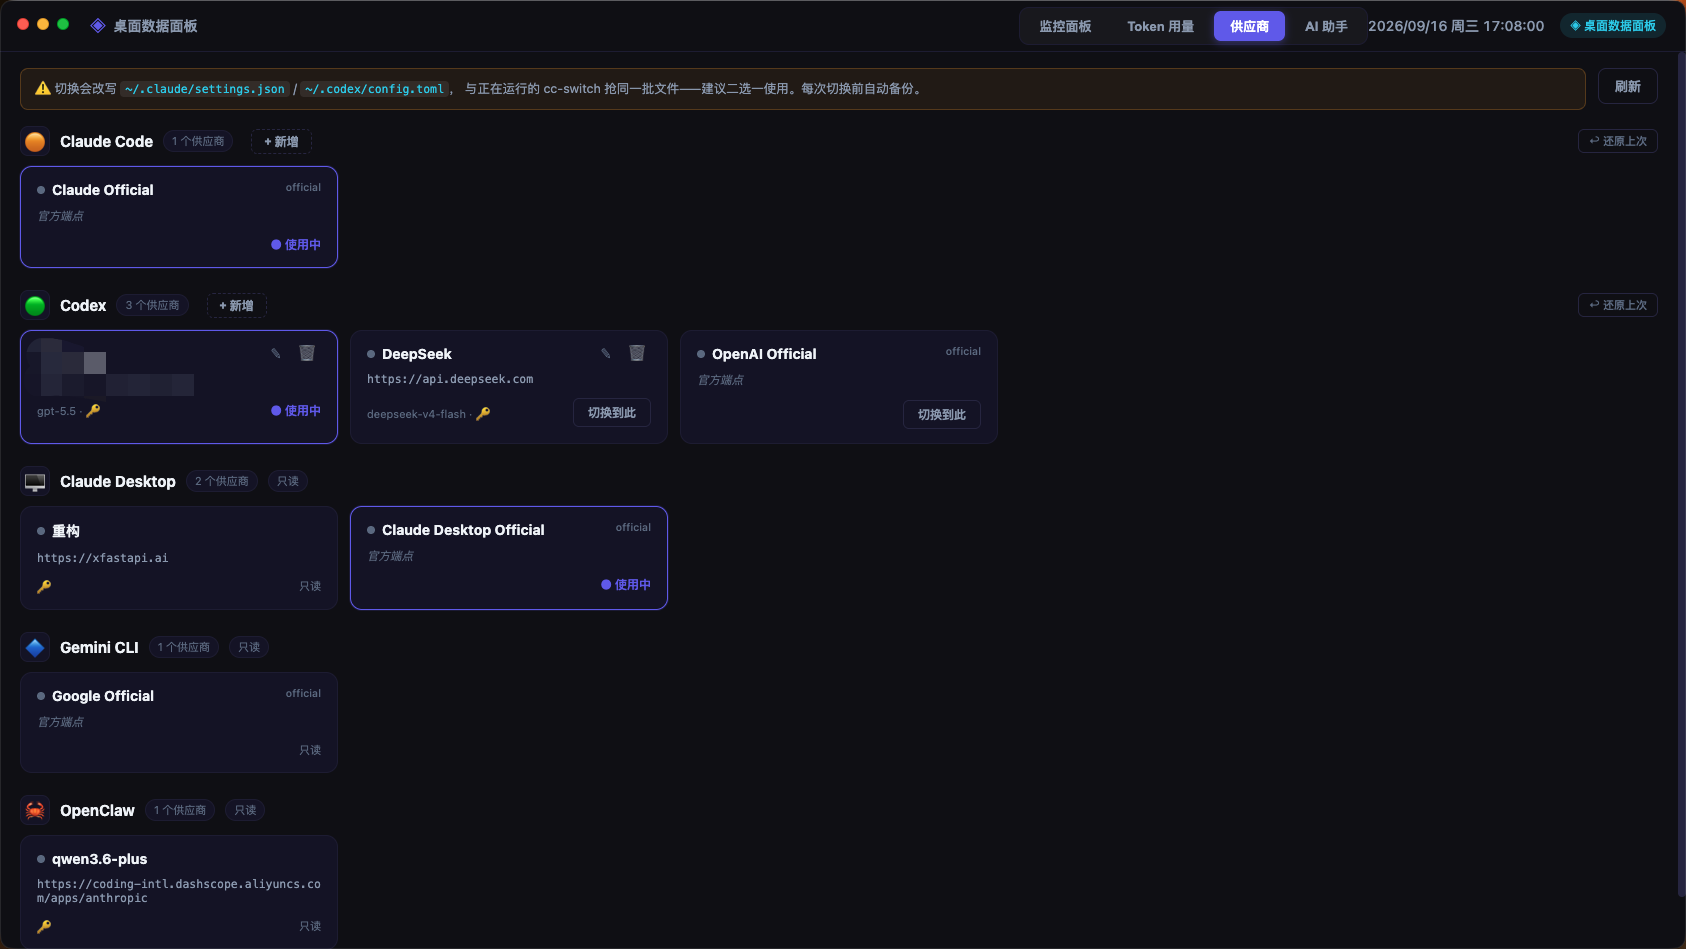
原理不复杂,就是帮你安全地改写那两个配置文件:
- Claude Code → 改
~/.claude/settings.json里env的ANTHROPIC_BASE_URL/ANTHROPIC_AUTH_TOKEN,只动这几个键,你原来的 hooks、权限之类的配置一个不碰; - Codex → 改
~/.codex/config.toml:保留公共段(mcp_servers/notify/projects等),只替换供应商片段(model_provider/model/[model_providers.*]),再更新~/.codex/auth.json里的 key。
关键是别把用户配置改坏,所以加了几道保险:
- 写之前先备份:把目标文件按时间戳复制到
~/.cc-dashboard/provider_backups/,每个文件留最近 20 份,页面上每个工具都有个「↩ 还原上次」; - 原子写 + 写后校验:先写临时文件再 rename,写完再读回来 parse 一遍确认没写坏;
- 密钥不走命令行参数:新增/编辑供应商时,key 是通过子进程的 stdin 传进去的,不会出现在进程参数列表里(
ps看不到)。供应商库存在本机~/.cc-dashboard/providers.json,权限600。
小提醒:它改的是和 cc-switch 同一批配置文件,两个一起用会互相覆盖,建议二选一。这页的切换能力就是仿写 cc-switch 的核心逻辑,首次会从它的库里把供应商导进来,之后就在面板里自己管了。
四、AI 工作日志助手
第三页,我用来做每日复盘。
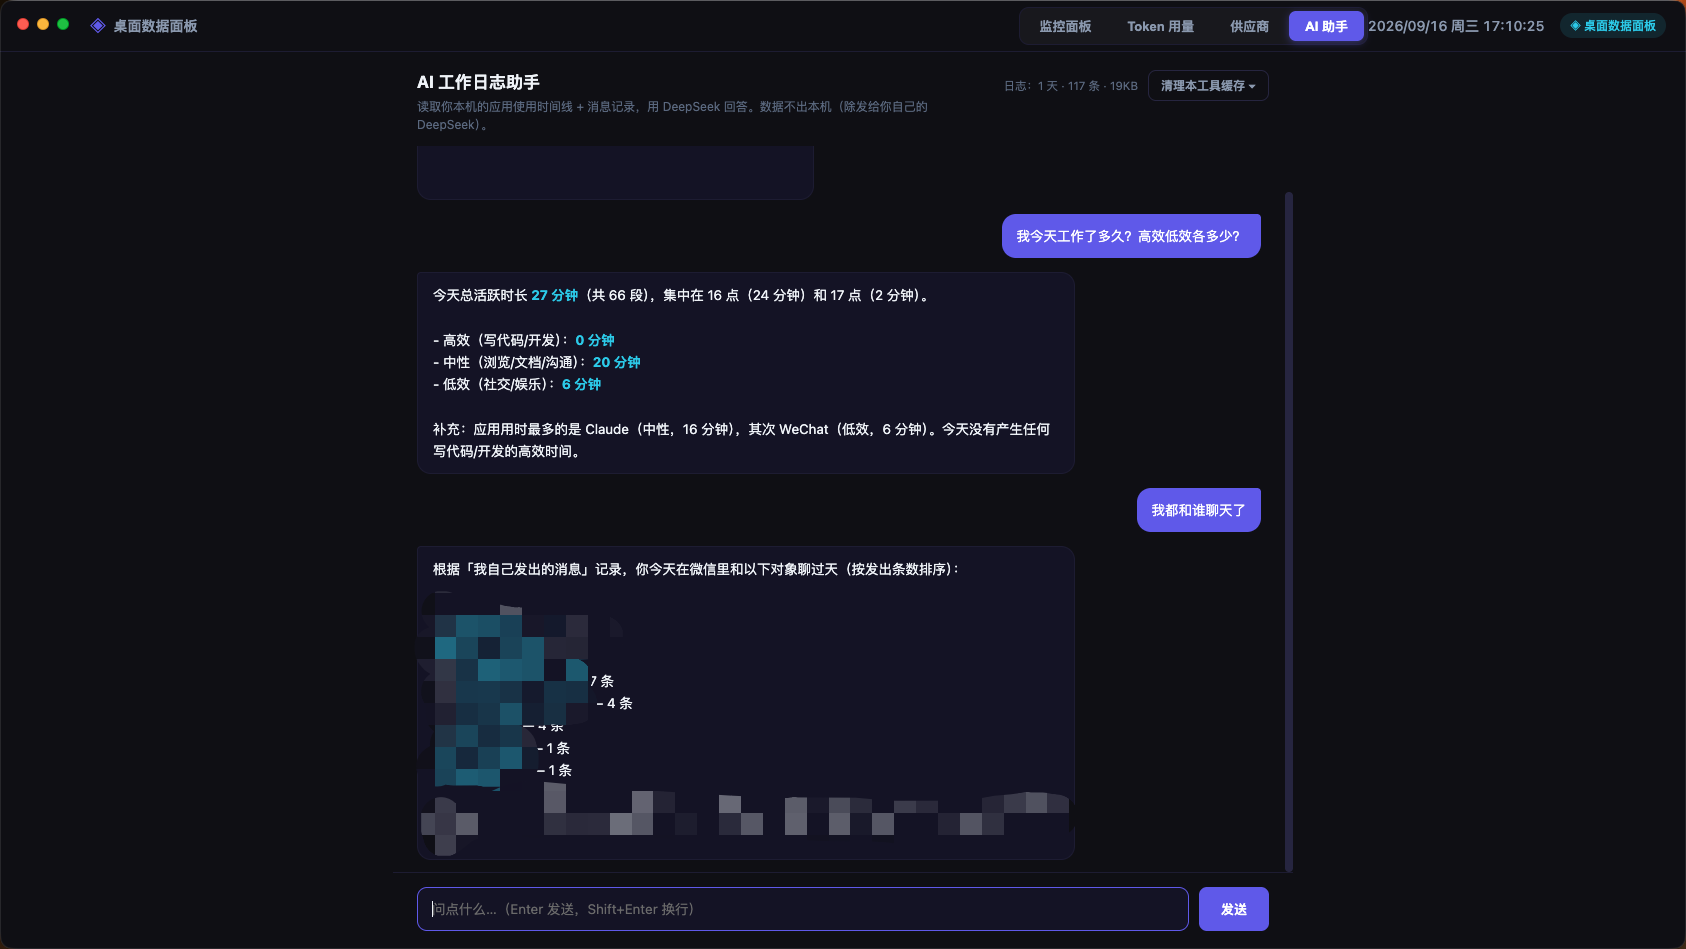
它读的是面板自己攒的两份本地日志:
~/.cc-dashboard/activity/YYYY-MM-DD.jsonl——应用使用时间线,每次前台应用切换记一段{app, start, end, durationSec};~/.cc-dashboard/notifications/YYYY-MM-DD.jsonl——收到的消息/通知,每条一行{time, app, title, body}。
后端 ai_assistant.py 把当天这两份日志聚合成上下文,再丢给 DeepSeek 回答。聚合时做了两件事:
- 应用用时按「效率」归类:写代码/终端/IDE 算高效,浏览器/文档/沟通算中性,社交/视频/音乐算低效。分类表就摊在脚本顶上,随手能改。有个小原则——未知应用默认算「中性」,不武断judged成低效;
- 消息按会话归类,包括「我自己发出去的消息」也单独拎出来,这样能问它「我今天回复某人的语气怎么样」。
于是就能问它:今天工作了多久、高效低效各多少、几点在干嘛、都和谁聊了。上面截图里那两个回答就是实时跑出来的。
这里必须强调隐私:DeepSeek 的 key / base 从 .env 读,用的是你自己的 key、发的是你自己的数据;除了发给你自己配的那个大模型,数据不出本机。页面右上角还有个「清理本工具缓存」,按天清活动/通知日志、清临时解密缓存——只清面板自己攒的东西,绝不碰源数据。
五、关于消息聚合 & 隐私
首页那块「消息通知」聚合了微信、钉钉、企业微信的未读和新消息(截图里聊天内容我都打码了)。至于怎么从这三家客户端把本地消息读出来——涉及各家客户端的加密库逆向,这篇不展开,点到为止。 这部分我在仓库里也没放取密钥的方法,.env 里的密钥更是每个人自己在自己机器上获取、绝不入库。
整个工具的定位是:只读你自己的、在你自己机器上的数据,只发给你自己配的 AI。 没有任何数据上传到我这或第三方。.env 含明文密钥,已经在 .gitignore 里,别手滑提交上去。
结尾
代码已经开源,技术栈就是 Electron + Python + 一点 Swift,没有花哨依赖。Token 账单、供应商切换、手绘 SVG 图表这几块是完全通用的,抠出来单独用也行。有需要的自取,按 README 配好 .env 就能 npm start 跑起来。
评论 0