宇树 R1 迎宾机器人(一):整体架构与人脸识别引擎
给公司年会做的迎宾机器人:感知/决策/表达三层架构、本地与机器人双模式,用 InsightFace 提取人脸特征、余弦相似度向量化匹配,识别部分一台带摄像头的电脑就能复现。
这段时间给公司年会做了个迎宾机器人:宇树 R1 站在门口,认出来的人它就喊名字打招呼、挥手致意,没人的时候还会自己左右张望。这一篇先讲整体怎么搭的、以及最核心的人脸识别部分——识别这块不用机器人,一台带摄像头的电脑就能复现。
它到底在做什么
一句话:摄像头看到人脸 → 在特征库里比对认出是谁 → 用语音喊出名字、挥手、亮灯。做成年会迎宾就是——熟人一进门,机器人喊"张三先生你好,欢迎光临",同时抬手挥两下。
拆开看是三层,每一层我都留了"退路",这样没机器人时也能开发调试:
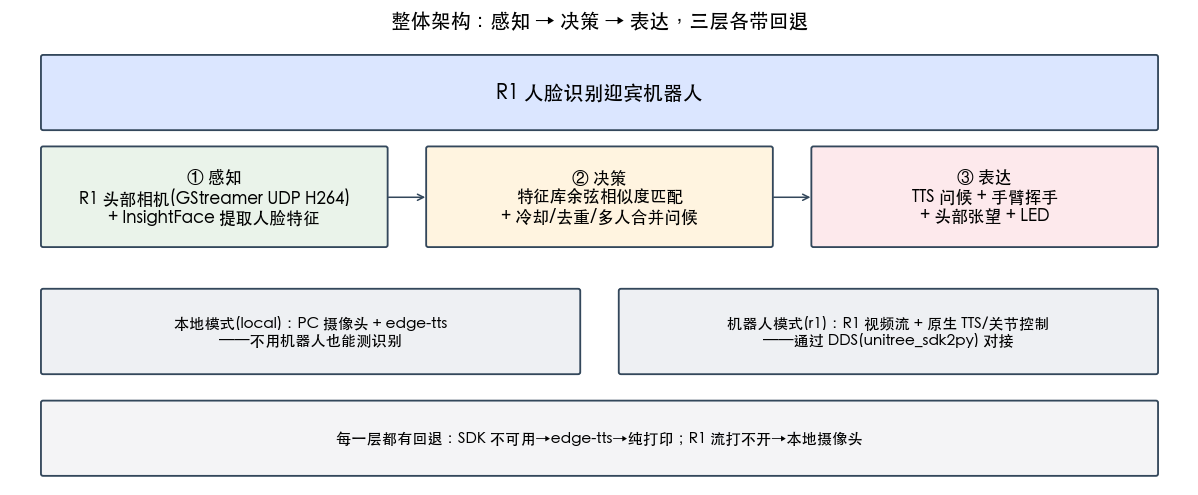
- ① 感知:拿到画面 + 找出人脸特征。机器人上用 R1 头部相机的视频流,本地开发用电脑摄像头。
- ② 决策:把人脸特征丢进特征库做比对,认出是谁;再处理"同一个人别反复喊""多个人合并成一句问候"。
- ③ 表达:语音问候 + 手臂挥手 + 头部张望 + LED 灯。机器人上用 R1 原生能力,本地用 edge-tts 发声。
两种运行模式一个参数切换:--mode local(电脑摄像头 + edge-tts,测识别用)和 --mode r1(R1 视频流 + 原生 TTS/关节控制,部署用)。这一篇聚焦感知和决策里的人脸识别,机器人相关的相机、语音、动作放到后面两篇。
人脸识别用 InsightFace,别自己造轮子
人脸识别我没有自己训模型,直接用开源的 InsightFace——它一步到位:给它一张图,它把图里每张脸检测出来、并为每张脸算一个 512 维的特征向量(embedding)。认人的本质就是:同一个人的两张脸,特征向量很接近;不同人差得远。 比对就是算两个向量的"像不像"。
先装环境(这几样在普通电脑上就能跑,用 CPU 即可):
pip install insightface onnxruntime opencv-python numpy
加载模型、提取特征,就这么点代码:
from insightface.app import FaceAnalysis
import numpy as np, cv2

_app = None
def get_app():
    global _app
    if _app is None:
        _app = FaceAnalysis(providers=["CPUExecutionProvider"])   # 用 CPU
        _app.prepare(ctx_id=-1, det_size=(640, 640))              # ctx_id=-1 即 CPU
    return _app

def extract_embedding(image_bgr):
    """检测人脸并提取特征,返回最大那张脸的 embedding"""
    faces = get_app().get(image_bgr)          # 一次返回图中所有人脸
    if not faces:
        return None
    face = max(faces, key=lambda f: (f.bbox[2]-f.bbox[0])*(f.bbox[3]-f.bbox[1]))  # 取最大的脸
    return face.embedding                     # 512 维向量
app.get(frame) 返回图里每张脸,每张脸带 bbox(人脸框)、kps(关键点)、embedding(特征向量)。录入时一般取画面里最大的那张脸(离镜头最近的),用人脸框面积挑。
判断"像不像":余弦相似度
两个向量像不像,用余弦相似度:把两个向量都归一化成长度 1,再做点积,结果在 -1 到 1 之间,越接近 1 越像。
def compare_embeddings(emb1, emb2):
    emb1 = emb1 / np.linalg.norm(emb1)        # 归一化
    emb2 = emb2 / np.linalg.norm(emb2)
    return float(np.dot(emb1, emb2))          # 点积 = 余弦相似度
实际用一个阈值来判"是不是同一个人"。我用的是 0.4:相似度 ≥ 0.4 就认为匹配上了。这个值可以调——调高更严格(宁可认不出也不认错),调低更宽松(容易认出但可能张冠李戴)。年会场景我宁愿偶尔认不出,也不想喊错名字,所以没敢调太低。
一次和整库比:向量化匹配
年会几百号人,来一张新脸要和库里每个人都比一遍。一个个 for 循环太慢,用 numpy 一次算完:把库里所有特征堆成一个矩阵,新脸向量和这个矩阵做一次矩阵乘法,就得到它和每个人的相似度,再取最大的那个。
class FaceMatcher:
    def __init__(self, threshold=0.4):
        self.threshold = threshold
        self.ids = []
        self.embeddings = None                 # 形状 (人数, 512) 的矩阵

    def load_from_db(self, db):
        rows = db.get_all_embeddings()         # [(person_id, 向量字节), ...]
        self.ids = [r[0] for r in rows]
        mat = np.array([np.frombuffer(r[1], dtype=np.float32) for r in rows])
        self.embeddings = mat / np.linalg.norm(mat, axis=1, keepdims=True)  # 每行归一化

    def match(self, embedding):
        if self.embeddings is None:
            return None, 0.0
        emb = embedding / np.linalg.norm(embedding)
        sims = self.embeddings @ emb           # 一次矩阵乘 → 和每个人的相似度
        idx = int(np.argmax(sims))             # 最像的那个
        sim = float(sims[idx])
        return (self.ids[idx], sim) if sim >= self.threshold else (None, sim)
关键就是 self.embeddings @ emb 这一行:库里 500 人就是一个 500×512 的矩阵,乘一个 512 的向量,一步得到 500 个相似度。几百人的库,匹配一张脸是毫秒级,实时视频完全跟得上。
特征库怎么存
人脸特征存在 SQLite 里,每个人一条记录:姓名、部门、职位等信息,加上那串 512 维向量(float32 直接存成二进制 blob)。录入的时候上传一张照片,提取 embedding 存库;识别的时候把整库的 embedding 读出来给 FaceMatcher。
# 向量存库:numpy 数组转字节
emb_bytes = embedding.astype(np.float32).tobytes()
# 读出来:字节转回 numpy
emb = np.frombuffer(emb_bytes, dtype=np.float32)
录入界面我用 Gradio 搭了个网页(pip install gradio),打开浏览器就能上传照片、填信息、录入人员,不用手写 SQL。这块是纯 Web,跟机器人无关,就不展开了。
先在电脑上把识别跑起来
到这一步,不用机器人你就能验证识别管不管用:装好上面的库,用电脑摄像头读一帧、app.get(frame) 拿到人脸、和你录入的几张脸比一比。核心循环就是"读帧 → 提特征 → 匹配 → 画框显示名字和相似度"。识别这块跑通了,剩下的就是把它接到机器人身上——怎么接 R1 的相机和语音、怎么让它挥手,是接下来两篇的事。
下一篇:接住 R1 的头部相机视频流(GStreamer)、让它用原生 TTS 说话、以及用遥控器一键启停。
评论 0